ラベル データ解析 の投稿を表示しています。 すべての投稿を表示

2024-07-12

SciPy を利用した数値積分

SciPy は Python のための科学的ツールのオープンソース・ライブラリとして開発されています。SciPyは、NumPy をベースにしていて、統計、最適化、積分、線形代数、フーリエ変換、信号・イメージ処理、遺伝的アルゴリズム、ODE (常微分方程式) ソルバ、特殊関数、その他のモジュールを提供しています。

Wikipedia より引用、編集

時系列のトレンドデータを解析する際に、ある区間を数値積分して、その(符号付きの)面積を評価したい場合があります。こういう場合、その面積の精度はそこそこで良いし、面積の単位とかを問題にするわけでもないので、前提条件を決めて数値積分するルーチンを自前で作成して使っていましたが、SciPy に数値積分するパッケージがあるので利用してみました。

下記の OS 環境で動作確認をしています。

RHEL 9.4 x86_64
Python 3.12.1
jupyterlab 4.2.3
matplotlib 3.9.1
numpy 2.0.0
pandas 2.2.2
scipy 1.14.0

サンプルデータ

今回使用するデモ用のサンプルは、気象庁の過去の気象データ・ダウンロード・サイト [1] からダウンロードした、東京における 2023 年の気温データです。利用しやすいように加工しました。下記に CSV ファイルをダウンロードできるようにしました。

2023_temp_data.csv

以下、JupyterLab で確認しています。

CSV データの読み込み

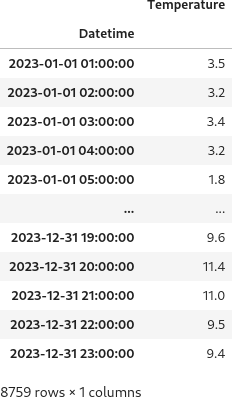
下記のようにして、CSV ファイルを Pandas のデータファイルとして読み込みます。

import pandas as pd

file = '2023_temp_data.csv'
df = pd.read_csv(file, index_col=0, parse_dates=True)
df

データフレームのインデックスに日時列を割り当てています。一時間毎の気温データです。

データの視覚化

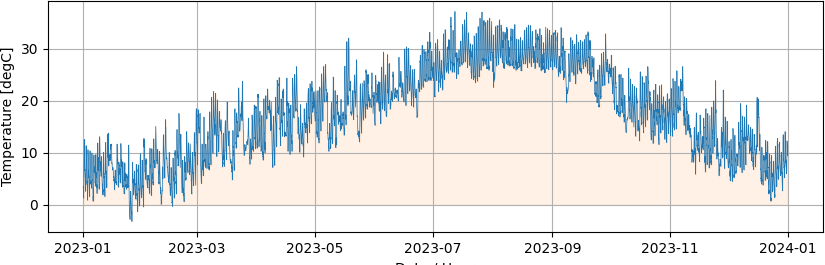
Matplotlib でデータを視覚化します。数値積分は下記プロットのオレンジ色の領域の(符号付き)面積を求めることになります。

import matplotlib.pyplot as plt

plt.rcParams["figure.figsize"] = (10,3)
fig, ax = plt.subplots()

ax.plot(df, lw=0.5, c='C0')
ax.fill_between(df.index, df['Temperature'], color='C1', alpha=0.1)
ax.set_xlabel('Date / Hour')
ax.set_ylabel('Temperature [degC]')
ax.grid()

plt.savefig('temperature_002.png')
plt.show()

積分する値の見積り

一年分の気温データですので、気温の平均値に一年 356 日を乗じてどの程度の量になるか見積もります。

import numpy as np

area_est = np.mean(df['Temperature']) * 365
print('mean * 365 days : %.3f' % area_est)
mean * 365 days : 6459.058

この計算だと大体 6000 台の数量です。平均値を使って算出したこの数量は、案外、積分する値の妥当な推定値になっているかもしれませんが…、とにかく数値積分をしてみましょう。

データフレームのデータは一時間毎のデータですので、数値積分した数量が、平均値と日数で見積もった数量と同程度のオーダーになるようにします。具体的には、日時を UNIX タイムスタンプ(秒)に変換し、これを 24 x 60 x 60 で割って、秒から日へ大きさを調整します。この数列を x とします。

y はもちろん気温データ列になります。

x = np.array([t.timestamp() / (24 * 60 * 60) for t in df.index])
y = np.array(df['Temperature'])

SciPy による数値積分

SciPy の integrate パッケージで利用できる、台形公式 (integrate.trapezoid)、シンプソンの公式 (integrate.simpson) それぞれの方法で数値積分をしました。

from scipy import integrate

area1 = integrate.trapezoid(y, x=x)
print('Trapezoidal rule : %.3f' % area1)

area2 = integrate.simpson(y, x=x)
print('Simpson\'s rule   : %.3f' % area2)
Trapezoidal rule : 6458.052
Simpson's rule   : 6458.646

今回の1万個に満たないデータ数では、台形公式とシンプソンの公式で計算時間に差異を感じませんでした。どちらの方法でも概ね同じ結果が出ていますが、用途によっては精度が必要な場合もあるでしょう。頻繁に利用する場合には、必要な精度と計算量(リソース)を評価して、どちらかに決める必要があります。

参考サイト

  1. 気象庁|過去の気象データ・ダウンロード
  2. trapezoid — SciPy Manual
  3. simpson — SciPy Manual


ブログランキング・にほんブログ村へ bitWalk's - にほんブログ村 にほんブログ村 IT技術ブログ オープンソースへ
にほんブログ村

オープンソース - ブログ村ハッシュタグ
#オープンソース


このエントリーをはてなブックマークに追加

2024-05-11

Prophet を使ってみた

Prophet は、R および Python 用に実装した時系列データの予測手法で、非線形のトレンドに年間、週間、日次の季節性、さらに休日効果をフィッティングする加法モデルに基づいています。強い季節効果と数シーズンの過去データを持つ時系列データの解析に最適です。Prophet は欠損値やトレンドのシフトに対してロバストで、一般的に外れ値に対してもうまく対処できます。

Prophet は Facebook の Core Data Science チームによってリリースされたオープンソースのソフトウェアです。CRAN と PyPI からダウンロード可能です。

Prophet のプロジェクトサイトより引用、翻訳・編集

最近、思っているような時系列解析ができずに苦しんでいます。あれこれ試している中で、Python の statsmodels パッケージの Unobserved components models [1] を試した結果を本ブログでまとめましたが [2]、今回は Prophet を試してみました。

下記の OS 環境で動作確認をしています。

Fedora Workstation 40 x86_64
Python 3.12.2
jupyterlab 4.1.8
matplotlib 3.8.4
pandas 2.2.2
prophet 1.1.5
statsmodels 0.14.2

statsmodels パッケージは、今回はデータセットを利用するためだけに必要になります。

今回の解析は JupyterLab を使用しています。

必要なライブラリーの読み込み

最初に、必要なライブラリーを読み込んでおきます。

import matplotlib.pyplot as plt
import pandas as pd
from prophet import Prophet
 
import statsmodels.datasets.co2 as co2

データセット

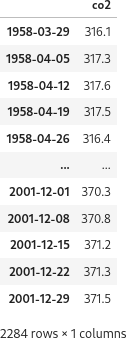
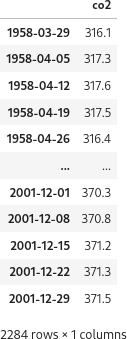
今回も過去記事 [2] と同じ、statsmodels に用意されている CO2 濃度のデータセットを利用します。

co2_raw = co2.load().data
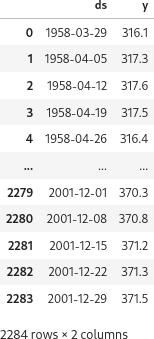
co2_raw


Prophet へ入力するには、ds(datestamp = 時刻情報)カラムと y カラムにデータフレームを整形する必要があります。y は予測したい測定値です。今回は次のようにしました。

df = co2_raw.reset_index()
df.columns=['ds', 'y']
df


過去記事 [2] では、欠損値の少ない期間を選んで、月平均を算出して、そのデータを使用しましたが、今回は欠損値を気にせず、すべてのデータを使います。

モデルの作成と学習

モデルを作成して、用意したデータフレームで学習します。

model = Prophet()
model.fit(df)

予測

過去記事 [2] と同じ期間の予測をしてみます。モデルの make_future_dataframe メソッドで期間(日)を指定して予測用のデータフレームを作成します。

future = model.make_future_dataframe(periods=365 * 4 + 3)
future.tail()


モデルの predict メソッドで予測します。

forecast = model.predict(future)
forecast[['ds', 'yhat', 'yhat_lower', 'yhat_upper']].tail()


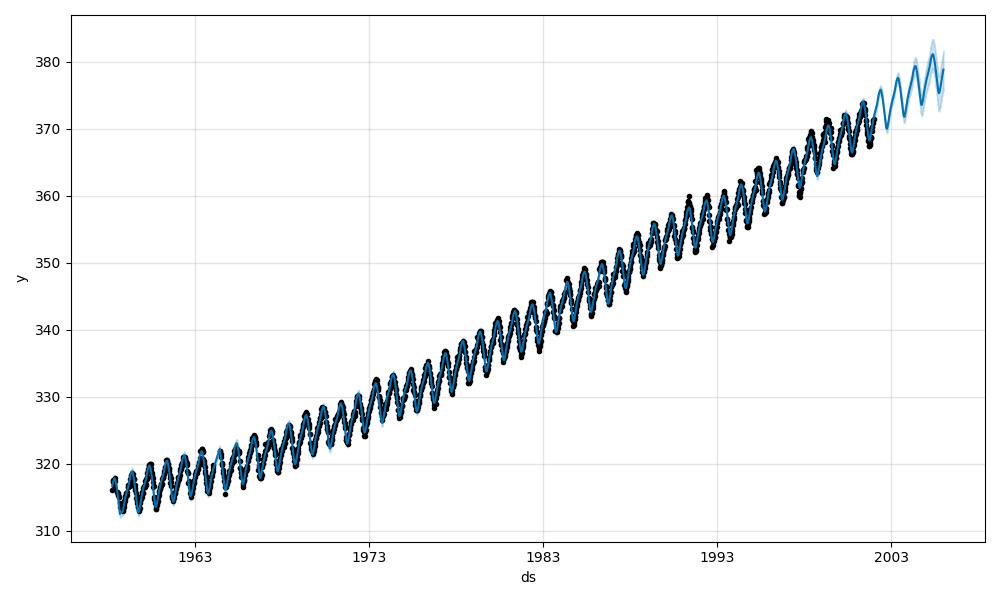
予測結果をプロットします。

fig1 = model.plot(forecast)
# plt.savefig('trend_analysis_11/fig-001.png')


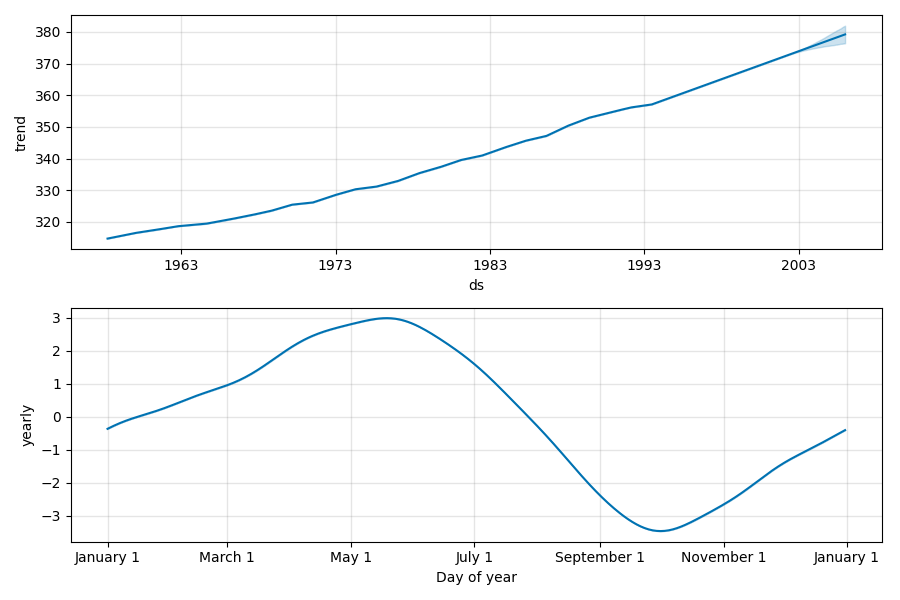
plot_components メソッドで成分を確認できます。

fig2 = model.plot_components(forecast)
# plt.savefig('trend_analysis_11/fig-002.png')


今回の解析では、トレンド成分と月別の成分がプロットされましたが、Prophet ではカレンダー情報を持っているようで、もし曜日依存するようであれば、曜日毎のプロットも表示されます。

まとめ

Prophet の基本的な使い方は scikit-learn のモデルと同じで、個人的には使いやすいと感じました。なにより欠損値に強く、周期変動を指定しなくとも解析してくれるのが嬉しいです。ただ、まだ全然使い込んでいません。まずは具体的なデータ解析を通じて使いこなせるようにしたいです。

参考サイト

  1. statsmodels.tsa.statespace.structural.UnobservedComponents - statsmodels
  2. bitWalk's: 【備忘録】Unobserved components モデル [2024-05-06]
  3. Prophet | Forecasting at scale.
  4. Prophetを使ってサクッと時系列データ予測をやる #Python - Qiita [2023-04-08]
  5. 将来予測で用いられるライブラリ「Prophet」 | スキルアップAI Journal [2023-06-13]
  6. Prophetによる時系列データ予測: Analyst-in-the-Loop [2024-01-04]
  7. 【Python 入門】Prophet を使った時系列データ分析と Plotly による可視化! | キカガクブログ [2024-04-15]


ブログランキング・にほんブログ村へ bitWalk's - にほんブログ村 にほんブログ村 IT技術ブログ オープンソースへ
にほんブログ村

オープンソース - ブログ村ハッシュタグ
#オープンソース


このエントリーをはてなブックマークに追加

2024-05-06

【備忘録】Unobserved components モデル

Statsmodels は、データの探索、統計モデルの推定、統計検定を算出できる Python パッケージです。様々なタイプのデータや各推定量に対して、広範な記述統計量,統計検定,プロット関数、そして(サンプルに利用できる)統計データを利用できます。SciPy パッケージの stats モジュールを補完します。

Wikipedia より引用、翻訳・編集

最近、思っているような時系列解析ができずに苦しんでいます。あれこれ試している中で、Python の statsmodels パッケージで Unobserved components models [1] を試して見たところ、大したチューニングもしていないのに、いかにももっともらしい予測が出たことに衝撃を受けたので、試したことを備忘録にしました。

下記の OS 環境で動作確認をしています。

Fedora Workstation 40 x86_64
Python 3.12.2
jupyterlab 4.1.8
matplotlib 3.8.4
pandas 2.2.2
statsmodels 0.14.2

今回の解析は JupyterLab を使用しています。

必要なライブラリーの読み込み

最初に、必要なライブラリーを読み込んでおきます。またプロットに共通な設定もしておきます。

import pandas as pd
import statsmodels.api as sm
import matplotlib.pyplot as plt
plt.rcParams.update({
    'font.size'      : 14,
    'axes.grid'      : True,
    'grid.linestyle' : '--',
    'figure.figsize' : [12, 6]
})

import statsmodels.datasets.co2 as co2

データセット

ちょうど参考サイト [2] で紹介されているサンプルを試していたので、そこで使用していたデータセットと同じく statsmodels に用意されている CO2 濃度のデータセットを利用して、同じように加工します。

co2_raw = co2.load().data
co2_raw


欠損が少ない 1965 年以降のデータから月次平均を算出して使用します。

df = co2_raw.loc['1965-01-01':]
df = df.resample('ME').mean() # 月の最終日で月次データに変換
df.index.name = "YEAR"
df


集計したデータをプロットします。

fig = plt.figure()
ax = fig.add_subplot(1, 1, 1)
ax.plot(df)

ax.set_title('CO2 Concentration')
ax.set_xlabel('Year')
ax.set_ylabel('ppmv')

# plt.savefig('trend_analysis_08/fig-001.png')
plt.show()


Unobserved components モデル

ここからは、参考サイト [3] で紹介されているやり方を、加工した CO2 濃度のデータセットをあてはめてみます。

※「空間状態モデル」というべきかもしれませんが、まだ全然理解できていないので知ったかぶりができず、さりとて、Unobserved components について(定着しているような)日本語の訳語を確認できなかったので、控えめに、そのままの表記にしています。

最初にモデルを定義して、(カルマンフィルダーで)フィッティングします。

model = sm.tsa.UnobservedComponents(
    df,
    level='local linear trend',
    seasonal=12,
)

results = model.fit()
RUNNING THE L-BFGS-B CODE

           * * *

Machine precision = 2.220D-16
 N =            4     M =           10

At X0         0 variables are exactly at the bounds

At iterate    0    f=  3.80232D+00    |proj g|=  8.88849D-02

At iterate    5    f=  2.31489D+00    |proj g|=  8.31771D-01
  ys=-1.847E+00  -gs= 2.050E-01 BFGS update SKIPPED

At iterate   10    f=  4.99810D-01    |proj g|=  1.27619D+00

 This problem is unconstrained.


At iterate   15    f=  3.45421D-01    |proj g|=  3.76042D-01

At iterate   20    f=  2.46012D-01    |proj g|=  8.57193D-02

At iterate   25    f=  2.45718D-01    |proj g|=  1.68724D-02

           * * *

Tit   = total number of iterations
Tnf   = total number of function evaluations
Tnint = total number of segments explored during Cauchy searches
Skip  = number of BFGS updates skipped
Nact  = number of active bounds at final generalized Cauchy point
Projg = norm of the final projected gradient
F     = final function value

           * * *

   N    Tit     Tnf  Tnint  Skip  Nact     Projg        F
    4     27     76      1     1     0   3.247D-03   2.457D-01
  F =  0.24571746957084589     

CONVERGENCE: REL_REDUCTION_OF_F_<=_FACTR*EPSMCH             

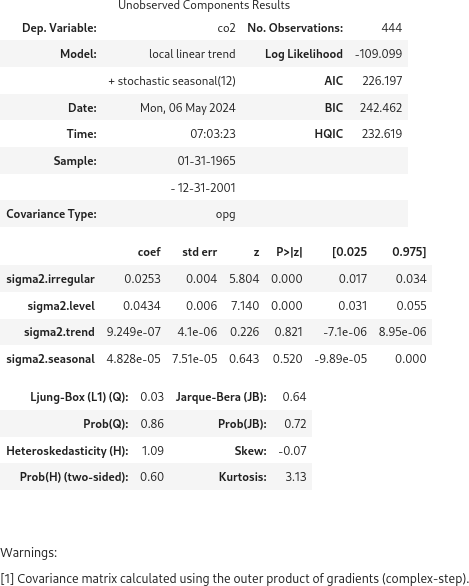
フィッティング結果のサマリーを表示できますが、経験不足で詳細を評価できません。

results.summary()


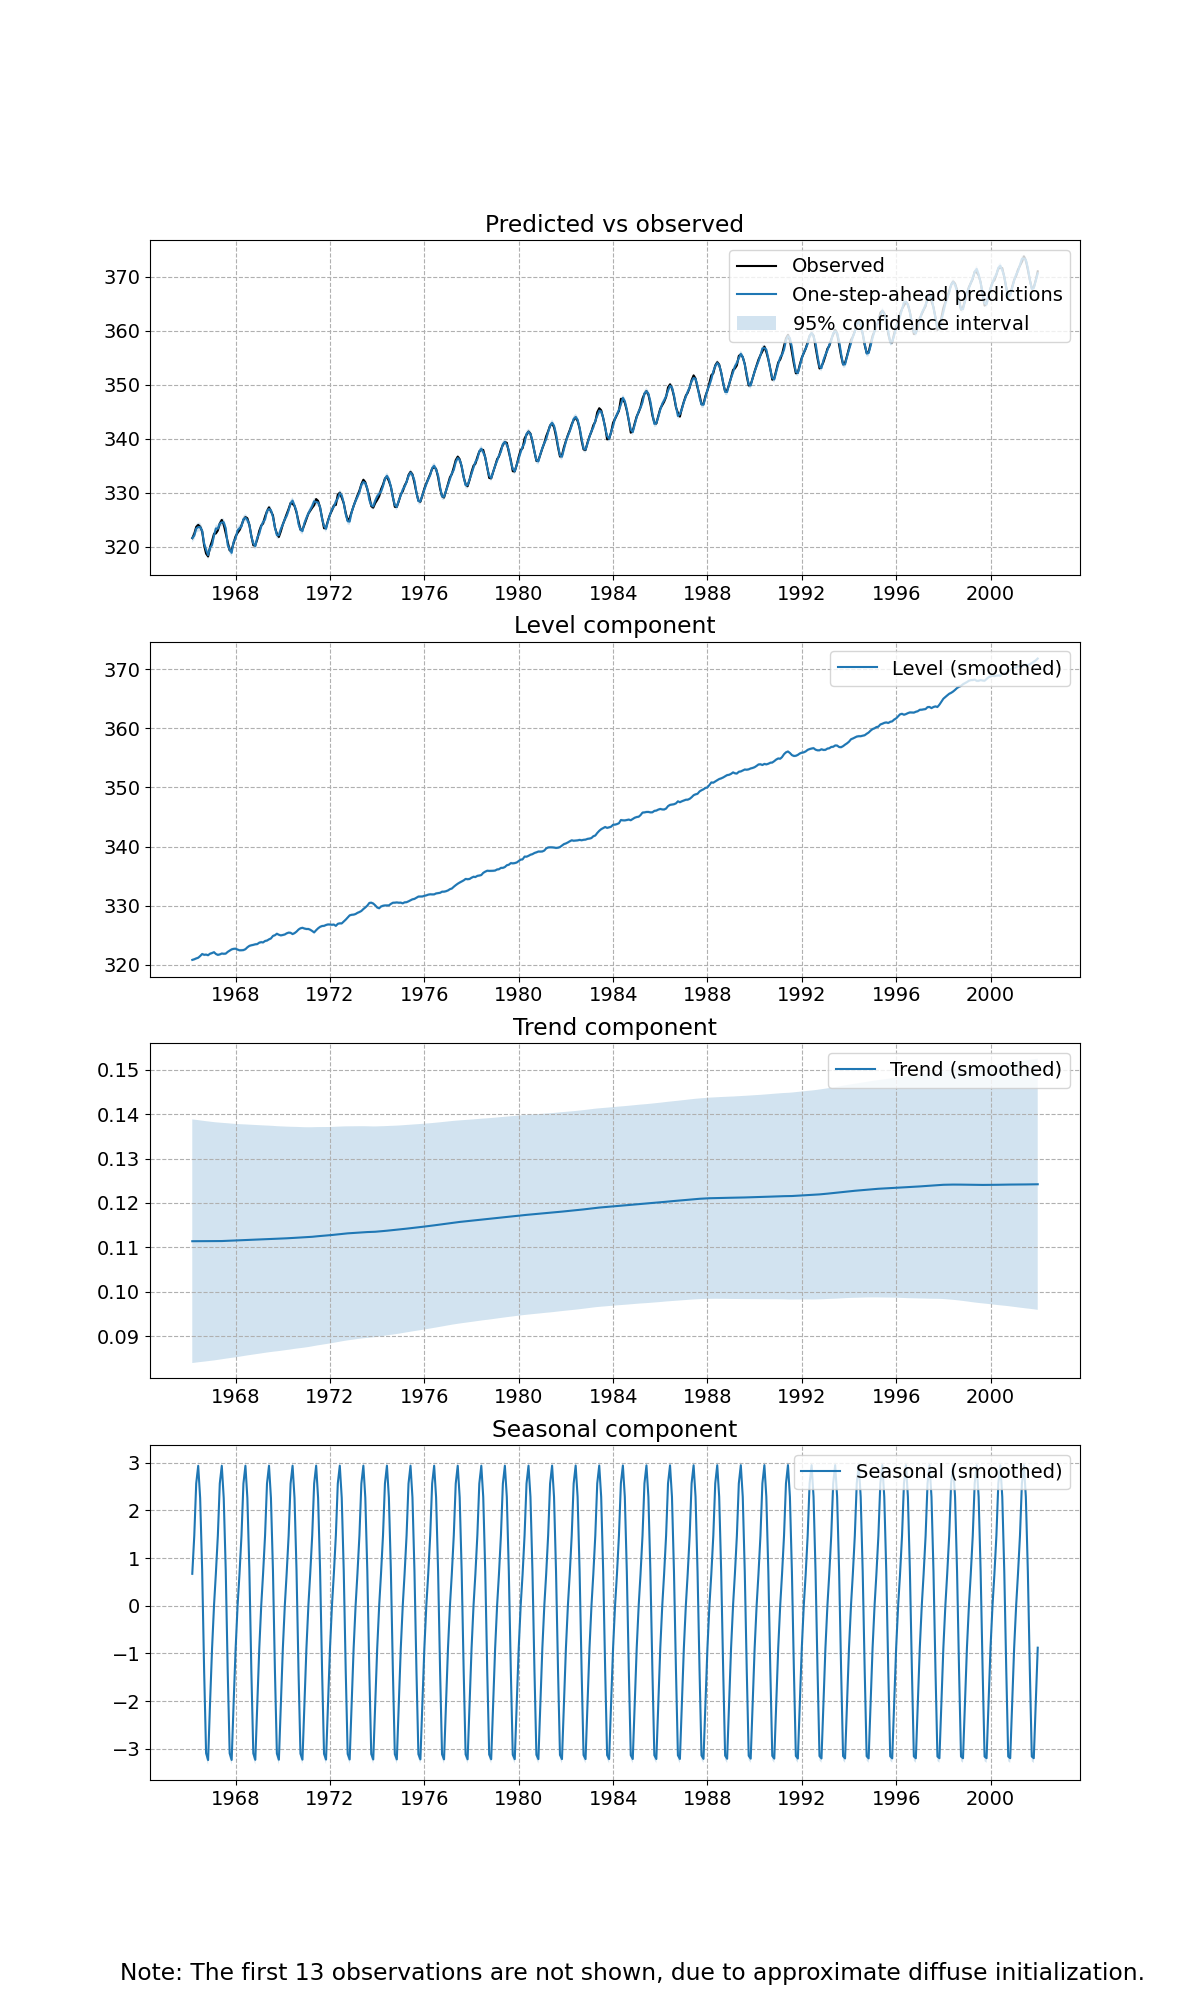
解析で分離した成分のプロットをします。

out = results.plot_components(figsize=(12, 20))
# plt.savefig('trend_analysis_08/fig-002.png')


1つ目のグラフは、観測値と予測値とその95%信頼区間を表しています。2つ目のグラフは、レベル成分(観測できない状態?)、3つ目のグラフは、トレンド成分とその信頼区間、4つ目のグラフは、季節成分(周期的変動)を表しています。

作成したモデルで未来を予測してみます。敢えて、一部の期間を学習データと予測データが重なるように設定しています。

# Prediction
prediction = results.predict('2000-01-31', '2005-12-31')

学習データ (Original) と予測データ (Predicted) を色を変えてプロットします。

fig = plt.figure()
ax = fig.add_subplot(1, 1, 1)

ax.plot(df, label='Original', color="C0")
ax.plot(prediction, label='Predicted', color="C1")

ax.set_title('CO2 Concentration')
ax.set_xlabel('Year')
ax.set_ylabel('ppmv')
ax.legend()

# plt.savefig('trend_analysis_08/fig-003.png')
plt.show()


学習データとテストデータを分けてモデルの予測精度を検証していませんが、なんとなく自然な予測ができているように見えます。あくまで視覚的な印象に過ぎません。もしかすると CO2 濃度は、周期的な変化を把握しておけば素直に上昇を予測できるのかもしれません。

まとめ

今回使ったデータセットではたまたま季節性(周期的な変動)をうまく表現できただけかもしれません。それに、実際に解析したいデータにはこれほど強い季節性がないので、自分がやりたい時系列解析では、このモデルをそれほど有望視する必要がないかもしれません。しかし、参考サイト [4] を読んで、「外生変数」とよばれる、時間によって変化しない情報を複数加えられることを知り、俄然もっと使ってみたくなりました。

参考サイト

  1. statsmodels.tsa.statespace.structural.UnobservedComponents - statsmodels
  2. Pythonで時系列予測に使える機械学習モデルの実行例まとめ #Python - Qiita [2023-09-19]
  3. 時系列解析の重要手法、状態空間モデルについて解説 | pipon AI Trend 最新AI情報をわかりやすく届けるメディア [2020-04-29]
  4. Pythonで時系列分析(状態空間モデル) - deepblue [2022-10-12]


ブログランキング・にほんブログ村へ bitWalk's - にほんブログ村 にほんブログ村 IT技術ブログ オープンソースへ
にほんブログ村

オープンソース - ブログ村ハッシュタグ
#オープンソース


このエントリーをはてなブックマークに追加

2024-03-26

【備忘録】Matplotlib と時系列データ ~ PySide6

PySide (Qt for Python) は、Qt(キュート)の Python バインディングで、GUI などを構築するためのクロスプラットフォームなライブラリです。Linux/X11, macOS および Microsoft Windows をサポートしています。配布ライセンスは LGPL で公開されています。

動作確認をするときには JupyterLab 上で Matplotlib でちゃちゃっプロットしていますが、常用する用途は PySide6 で GUI アプリにするのが常です。今回は Matplotlib を使った過去記事を PySide6 の GUI アプリにしてみました。

今回のテーマ
  • 当ブログの過去記事 [1] で扱った Matplotlib のチャートを PySide6 の GUI 上で扱えるように移植します。

下記の OS 環境で動作確認をしています。

Fedora Workstation 39 x86_64
Python 3.12.2
PySide6 6.6.2
pandas 2.2.0
matplotlib 3.8.3
scipy 1.12.0

サンプルデータ

サンプルデータは、過去記事 [1] と同じです。

下記からダウンロードできます。

temperature.csv

PySide6 の GUI 上の Matplotlib チャート

GUI 部分以外は過去記事のコードとほぼ同じになるように移植してみました。

qt_matplotlib_trend.py

実行結果を以下に示しました。PySide6 の GUI アプリとして識別できるように Qt のアイコンをタイトルバーに表示しましたが、デスクトップ環境によってはこのアイコンが表示されません(例:KDE Plasma)。

qt_matplotlib_trend.py の実行例

過去記事の Matplotlib の出力とほぼ同じになるように、今回はごくシンプルな GUI サンプルを作りましたが、実用では、メニューバーを付けたり、タブやボタンを付けたりと用途に応じた機能を追加しています。

参考サイト

  1. bitWalk's: 【備忘録】Matplotlib と時系列データ [2024-03-25]


ブログランキング・にほんブログ村へ bitWalk's - にほんブログ村 にほんブログ村 IT技術ブログ オープンソースへ
にほんブログ村

オープンソース - ブログ村ハッシュタグ
#オープンソース


このエントリーをはてなブックマークに追加

2024-03-25

【備忘録】Matplotlib と時系列データ

Matplotlib は、Python と NumPy のためのプロットライブラリです。Tkinter、wxPython、Qt、GTK のような汎用 GUI ツールキットを使ったアプリケーションにプロットを埋め込むためのオブジェクト指向 API を提供しています。

Wikipedia より引用、翻訳

Matplotlib によるチャート作成では、なんとなく時系列データの扱いに苦手意識を持っています。それでも最近はデータ解析で時系列データを扱うことが多くなってきているので、毎回調べ直さなくとも済むように、気になるトピックを備忘録として不定期にまとめていきます。

今回のテーマ
  • 時系列データを Matplotlib でトレンドチャートにして表示します。
  • さらに、データの加工例として SciPy を利用してスプライン補間した曲線を重ねて表示します。
  • y 軸を追加して、スプライン補間した曲線の微分値をプロットします。

下記の OS 環境で動作確認をしています。

Fedora Workstation 39 x86_64
Python 3.12.2
pandas 2.2.0
matplotlib 3.8.3
scipy 1.12.0

サンプルデータ

今回使用するサンプルデータは、参考サイト [1]、気象庁のサイトからダウンロートした、今年 3 月 1 日の気温データ(東京、1時間毎)を使用します。ただし、扱いやすいように少し整形して UTF-8 のエンコードで保存した CSV 形式のファイルです。

下記からダウンロードできます。

temperature.csv

ファイルの内容は以下のように「年月日時」と「気温」の二列のデータになっています。

年月日時,気温
2024/3/1 00:00:00,7
2024/3/1 1:00:00,7
2024/3/1 2:00:00,6.7
   :
   :

トレンドチャート

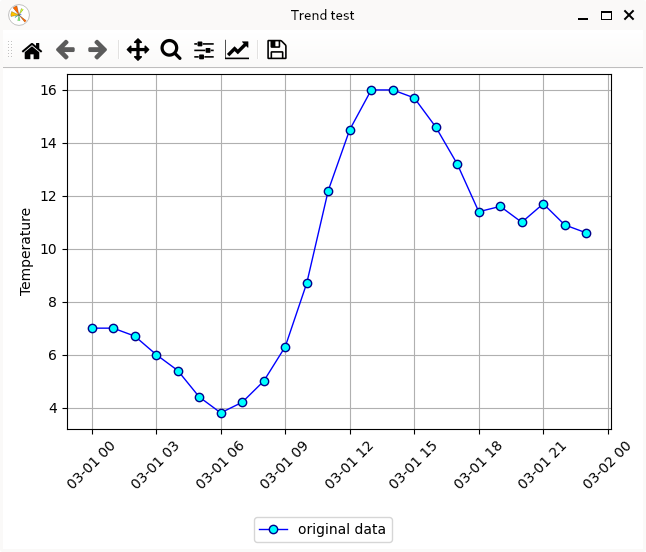
最初は、サンプルデータの CSV ファイルを読み込んで、データ点を時間順に◯で表示、データ間を直線でつないで表示します。

mpl_trend_01.py

実行例を示しました。

mpl_trend_01.py の実行例

ファイルの読み込み

今回のサンプルデータの最初の列「年月日時」は、重複無く順番に並んでいる情報ですので、これを Pandas データフレームのインデックスとして読み込みます。引数 index_col に列「年月日時」の列 0 を指定し、引数 parse_dates を True とします。すると、列「年月日時」が DatetimeIndex 型のインデックスとして読み込まれます [2]。

import pandas as pd

if __name__ == '__main__':
    csvfile = 'temperature.csv'
    df = pd.read_csv(csvfile, index_col=0, parse_dates=True)
    print(df)
    print(type(df.index))

実行時の出力は以下のようになります。

                       気温
年月日時                     
2024-03-01 00:00:00   7.0
2024-03-01 01:00:00   7.0
2024-03-01 02:00:00   6.7
   :
   :
   :
2024-03-01 22:00:00  10.9
2024-03-01 23:00:00  10.6
<class 'pandas.core.indexes.datetimes.DatetimeIndex'>

トレンドチャート

データフレームのインデックスが DatetimeIndex 型になっていると、Matplotlib でプロットする場合、x と y を指定せずともデータフレーム df を指定するだけでプロットできます。

import matplotlib.pyplot as plt
import pandas as pd

if __name__ == '__main__':
        :
        :
    fig, ax = plt.subplots()
    fig.canvas.manager.set_window_title('Trend test')

    line1 = plt.plot(
        df,
        linewidth=1,
        color='blue',
        marker='o',
        markersize=6,
        markeredgecolor='darkblue',
        markeredgewidth=1,
        markerfacecolor='cyan',
        label='original data'
    )

    plt.grid()
    plt.xticks(rotation=45)
    plt.ylabel('Temperature')
    fig.legend(loc='outside lower center')

    plt.subplots_adjust(top=0.99, left=0.1, bottom=0.25, right=0.95)
    plt.show()

時間軸の目盛ラベルの「月-日 時」は、ちょっと長いので、隣の目盛ラベルと重ならないように 45 度傾けました。また、プロットの余白を調節しています。

スプライン補間

チャート上のデータ点と次の点を直線で結ぶ、というのは無難な表現なのかもしれません。

しかし、このサンプルの 気温 のように、通常は連続的に値が変化しているのに、サンプリングの都合で離散的なデータになっている場合は、データ点間をなめらかな曲線でつなげて変化を近似したいこともあります。そうすればその曲線を微分することによって、近似的に変化点の評価をすることもできます。

そんな時に便利なのがB-スプライン曲線による補間です。ずいぶん昔から利用しているB-スプライン曲線なのですが、残念ながら、自分はしっかりとした説明ができません、ごめんなさい。🙇🏻

SciPy の interpolate(補間ツール)にある make_interp_spline でB-スプライン曲線を計算して、トレンドチャートに重ねてみます [3]。

まずはサンプルから。前出のサンプルをベースにしています。

mpl_trend_02.py

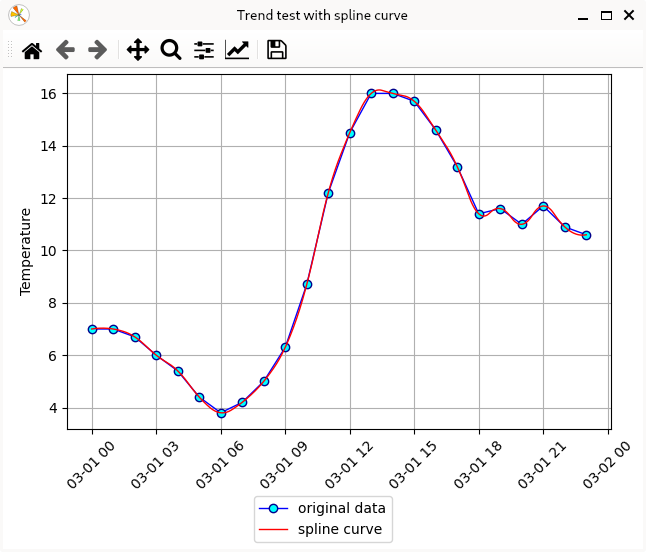
実行例を示しました。

mpl_trend_02.py の実行例

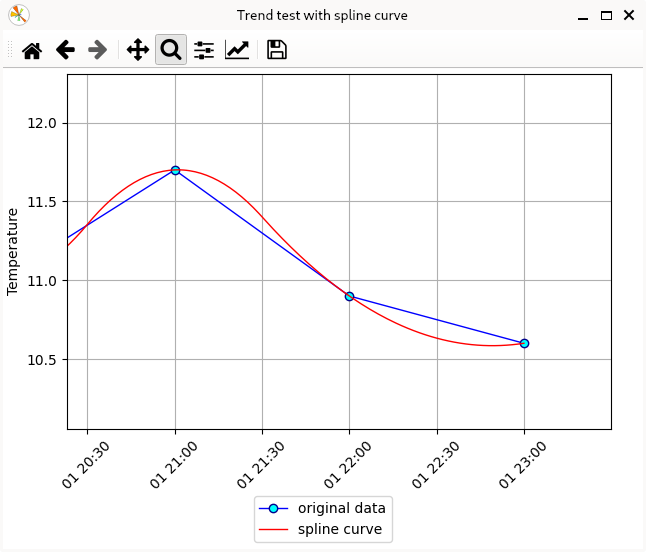
ナビゲーターバーの虫眼鏡アイコンをクリックして ON にするよ、プロット上をマウスでドラッグして指定した矩形領域を拡大できます。これで直線(青)とスプライン曲線(赤)の違いを確認できます。

mpl_trend_02.py の実行例 (2) 一部を拡大

時刻情報の扱い

時刻情報は、今回はデータフレームのインデックスに DateTimeIndex として読み込んでいますが、 SciPy ではこの時刻情報を数値としては扱えません。

DatetimeIndex(['2024-03-01 00:00:00', '2024-03-01 01:00:00',
               '2024-03-01 02:00:00', '2024-03-01 03:00:00',
               '2024-03-01 04:00:00', '2024-03-01 05:00:00',
               '2024-03-01 06:00:00', '2024-03-01 07:00:00',
               '2024-03-01 08:00:00', '2024-03-01 09:00:00',
               '2024-03-01 10:00:00', '2024-03-01 11:00:00',
               '2024-03-01 12:00:00', '2024-03-01 13:00:00',
               '2024-03-01 14:00:00', '2024-03-01 15:00:00',
               '2024-03-01 16:00:00', '2024-03-01 17:00:00',
               '2024-03-01 18:00:00', '2024-03-01 19:00:00',
               '2024-03-01 20:00:00', '2024-03-01 21:00:00',
               '2024-03-01 22:00:00', '2024-03-01 23:00:00'],
              dtype='datetime64[ns]', name='年月日時', freq=None)

ちょっと手間ですが、SciPy では以下のように時刻情報のインデックス df.index をタイムスタンプのインデックス ts に変換して利用することにします。タイムスタンプへの変換は、参考サイト [4] を参考にさせていただきました。

import pandas as pd
from pandas import DatetimeIndex, Index
        :
        :
        :
    ts: Index = df.index.map(pd.Timestamp.timestamp)
    print(ts)
Index([1709251200.0, 1709254800.0, 1709258400.0, 1709262000.0, 1709265600.0,
       1709269200.0, 1709272800.0, 1709276400.0, 1709280000.0, 1709283600.0,
       1709287200.0, 1709290800.0, 1709294400.0, 1709298000.0, 1709301600.0,
       1709305200.0, 1709308800.0, 1709312400.0, 1709316000.0, 1709319600.0,
       1709323200.0, 1709326800.0, 1709330400.0, 1709334000.0],
      dtype='float64', name='年月日時')

B-スプライン曲線の計算

時刻をタイムスタンプに変換した ts と、対応する気温データ df['気温'] で、補間するB-スプライン曲線(の係数)を計算する BSpline クラスのインスタンス bspl を生成します。次数は k で指定しますが、ここでは 2(二次)としています。

from scipy.interpolate import make_interp_spline, BSpline
        :
        :
        :
    bspl: BSpline = make_interp_spline(ts, df['気温'], k=2)

B-スプライン曲線を計算するために、サンプルと同じ時間内でより細かく刻んだ時刻列を用意します、ここでは(ちょっとやりすぎかもしれませんが)1分刻みで作成しました。

    x1: DatetimeIndex = pd.date_range(min(df.index), max(df.index), freq='1min')
    ts1: Index = x1.map(pd.Timestamp.timestamp)

プロット用には x1、B-スプライン曲線の計算用にはタイムスタンプに変換した ts1 を使います。

ts1 に対応したB-スプライン曲線の気温データ y1 を BSpline のインスタンス bspl で算出します。

    y1 = bspl(ts1)

B-スプライン曲線のプロット

プロットには x1 と y1 のペアを使います。

    line2 = plt.plot(
        x1, y1,
        linewidth=1,
        color='red',
        label='spline curve'
    )

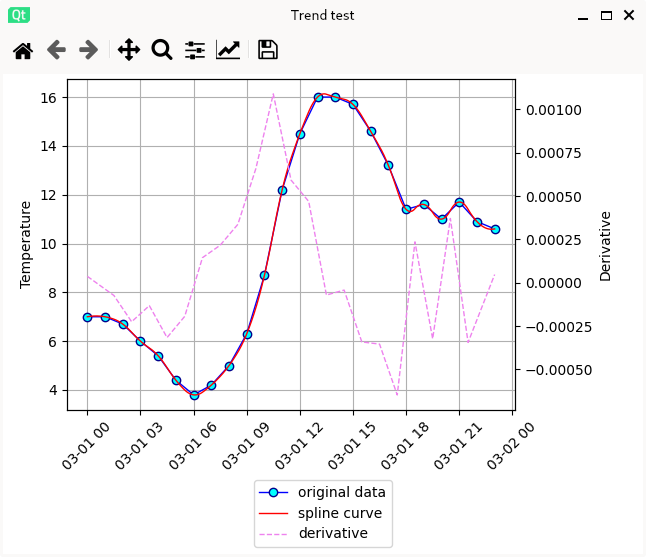
二つの y 軸で表示 [2024-03-26 追加]

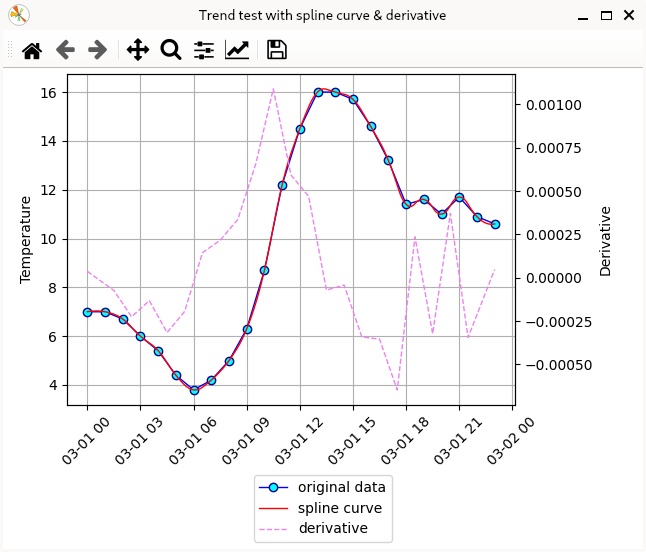
右側に二つ目の y 軸を追加して、B-スプライン曲線を微分した値を表示します。

微分値を算出する導関数の追加と軸を二つする都合でいくつか変更を加えたサンプルです。

mpl_trend_03.py

実行例を示しました。

mpl_trend_03.py の実行例

B-スプライン曲線の導関数

BSpline クラスの derivative(nu) (デフォルトは nu=1)メソッドで導関数のインスタンスを生成できます。

    dbspl = bspl.derivative(nu=1)
    dy1 = dbspl(ts1)

この dy1(一次微分値)を重ねてプロットするために、共通の x 軸に対して、右側にもうひとつの y 軸を追加してプロットすることにします。

二つの y 軸を扱うときの変更点

単純に x-y 軸でプロットする時には plt.plot(...) というように、plt(= pyplot)でプロットできましたが、二軸にすると、どちらに表示するかを軸 (ax) を基準にして指定する必要が出てきます。plt と ax のメソッドには微妙な違いがあるので、それに留意して書き換えます。

まず、ファイルから読み込んだ「年月日時」と「気温」の二列のデータのプロットは以下のようになります。ここは単純に plt を ax へ置き換えただけです。

    line1 = ax.plot(
        df,
        linewidth=1,
        color='blue',
        marker='o',
        markersize=6,
        markeredgecolor='darkblue',
        markeredgewidth=1,
        markerfacecolor='cyan',
        label='original data'
    )

B-スプライン曲線を表示する部分も同様に plt を ax へ置き換えます。

    line2 = ax.plot(
        x1, y1,
        linewidth=1,
        color='red',
        label='spline curve'
    )

次に二つ目の y 軸を追加して、B-スプライン曲線の導関数で算出した微分値 dy1 をプロットします。

y 軸の追加は、ax2 = ax.twinx() で生成した ax2 を使います [5]。

    ax2 = ax.twinx()
    line3 = ax2.plot(
        x1, dy1,
        linewidth=1,
        linestyle='dashed',
        color='violet',
        label='derivative'
    )

x 軸の目盛ラベルに傾けて表示する方法がちょっと面倒になっています。グリッドは ax を基準にしました。また余白の調節をしています。

    fig.legend(loc='outside lower center')

    for tick in ax.get_xticklabels():
        tick.set_rotation(45)
    ax.set_ylabel('Temperature')
    ax.grid()

    ax2.set_ylabel('Derivative')

    plt.subplots_adjust(top=0.99, left=0.1, bottom=0.3, right=0.8)
    plt.show()

参考サイト

  1. 気象庁|過去の気象データ検索
  2. pandas.DataFrame, Seriesを時系列データとして処理 | note.nkmk.me
  3. scipy.interpolate.make_interp_spline — SciPy v1.12.0 Manual
  4. pandasで日付・時間の列を処理(文字列変換、年月日抽出など) | note.nkmk.me
  5. matplotlib.axes.Axes.twinx — Matplotlib documentation


ブログランキング・にほんブログ村へ bitWalk's - にほんブログ村 にほんブログ村 IT技術ブログ オープンソースへ
にほんブログ村

オープンソース - ブログ村ハッシュタグ
#オープンソース


このエントリーをはてなブックマークに追加